Gdy środowisko testowe działa inaczej niż produkcja, a każda ręczna zmiana na serwerze wymaga notatki i odrobiny szczęścia, problemem zwykle nie jest sam backend, lecz sposób zarządzania infrastrukturą. Infrastruktura jako kod pozwala opisać sieć, serwery, bazy danych i usługi w plikach konfiguracyjnych, a potem odtwarzać je powtarzalnie, kontrolować w Git i wdrażać przez automatyzację. Pokazuję, jak działa ten model, czym różnią się Terraform, OpenTofu, CloudFormation i Pulumi, jak wygląda bezpieczny workflow oraz na jakie pułapki uważać.
Najważniejsze decyzje zapadają przed pierwszym poleceniem apply
- IaC opisuje pożądany stan infrastruktury zamiast wymagać ręcznej konfiguracji serwerów.
- Terraform i OpenTofu sprawdzają różnice między kodem, stanem i rzeczywistymi zasobami.
- Bezpieczny proces obejmuje Git, code review, plan oraz kontrolowane wdrożenie.
- Plik stanu może zawierać sekrety, dlatego powinien znajdować się w zabezpieczonym zdalnym backendzie.
- Największą korzyścią jest powtarzalność środowisk, a nie samo szybsze tworzenie serwerów.
Co naprawdę oznacza zarządzanie infrastrukturą przez kod
W klasycznym podejściu administrator tworzy zasoby w panelu chmurowym, ustawia reguły sieciowe, dodaje uprawnienia i zapisuje najważniejsze informacje w dokumentacji. Po kilku miesiącach trudno jednak odtworzyć kolejność zmian. Jeden ręcznie zmieniony parametr może sprawić, że środowisko testowe zacznie zachowywać się inaczej niż produkcja.
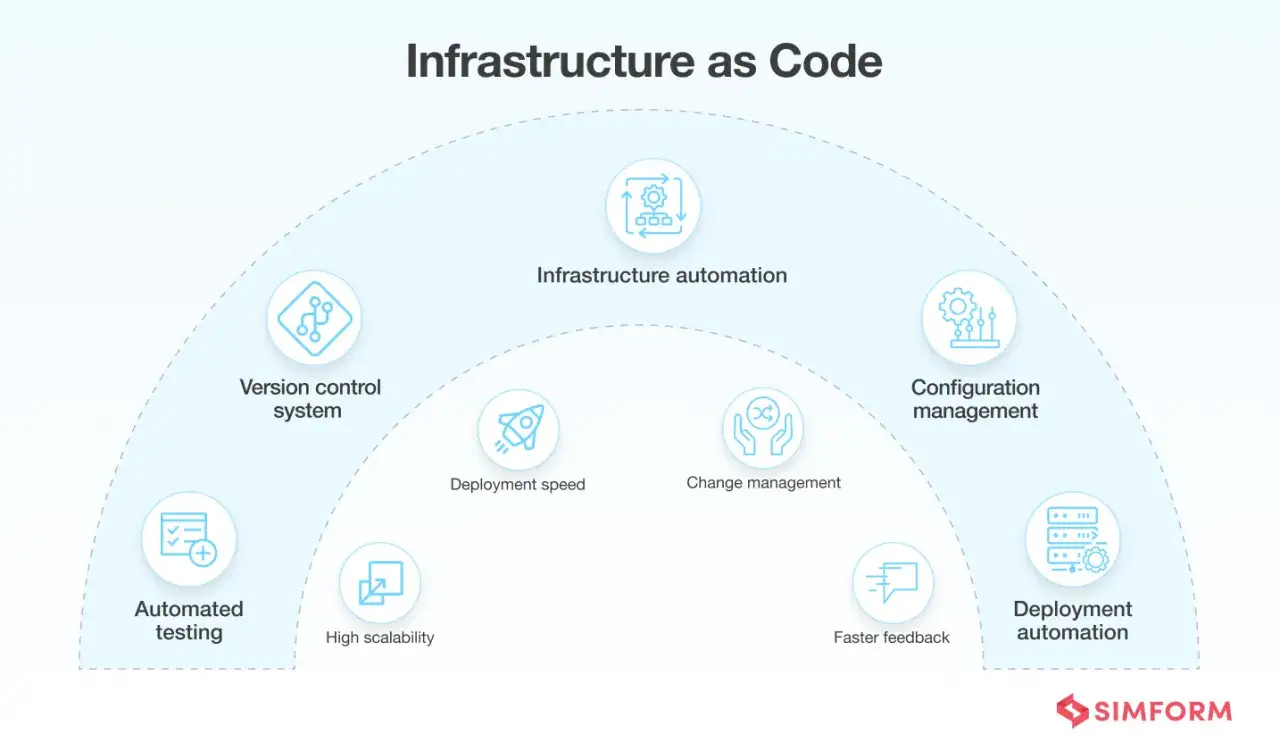
Model IaC przenosi te ustawienia do wersjonowanych plików konfiguracyjnych. Zamiast opisywać serię kliknięć, deklaruję, że aplikacja ma mieć na przykład sieć prywatną, bazę PostgreSQL, dwa serwery aplikacyjne, load balancer i określone reguły dostępu. Narzędzie porównuje ten opis z rzeczywistym środowiskiem i wykonuje potrzebne operacje.
Najważniejsze słowo to „deklaruję”. Kod zwykle opisuje pożądany stan, a nie dokładną kolejność tworzenia każdego zasobu. Silnik sam buduje zależności, dlatego wie, że baza musi mieć sieć, a serwer aplikacyjny powinien otrzymać właściwą grupę bezpieczeństwa.
IaC a skrypty administracyjne
Skrypt Bash lub Python może utworzyć serwer, zainstalować pakiety i uruchomić usługę. To przydatne podczas konfiguracji systemu, ale sam skrypt często nie wie, czy zasób już istnieje, czy został zmieniony ręcznie i czy ponowne uruchomienie jest bezpieczne.
Narzędzia deklaratywne dążą do idempotencji, czyli sytuacji, w której wielokrotne zastosowanie tej samej konfiguracji prowadzi do tego samego rezultatu. Skrypt nadal może być częścią procesu, lecz nie powinien zastępować pełnego modelu infrastruktury, gdy zarządzamy wieloma środowiskami.
Jak wygląda cykl od pliku konfiguracyjnego do działającej usługi
Typowy cykl zaczyna się od plików w repozytorium. Zmiana liczby instancji, wersji obrazu Dockera albo reguły sieciowej trafia do pull requesta tak samo jak zmiana w kodzie aplikacji. Dzięki temu można sprawdzić, kto ją przygotował, dlaczego powstała i jaki będzie jej wpływ.
- Write - opisuję zasoby i ich parametry w kodzie.
- Init - inicjalizuję narzędzie i pobieram wymagane providery lub moduły.
- Validate - sprawdzam składnię, formatowanie i podstawowe reguły.
- Plan - oglądam listę zasobów, które zostaną utworzone, zmienione albo usunięte.
- Review - druga osoba ocenia kod i plan, zwłaszcza zmiany dotyczące sieci, IAM oraz danych.
- Apply - zatwierdzony plan jest wykonywany w docelowym środowisku.
W Terraformie i OpenTofu polecenie plan nie modyfikuje infrastruktury. Pokazuje różnicę między konfiguracją, zapisanym stanem i zasobami odczytanymi z API dostawcy. Dopiero apply wykonuje operacje, dlatego plan powinien być częścią code review, a nie tylko prywatnym testem autora.
terraform init
terraform fmt -check
terraform validate
terraform plan -out=tfplan
terraform apply tfplan
W automatyzacji dobrze rozdzielić plan od wdrożenia. Pull request może uruchamiać walidację i plan, natomiast apply powinien odbywać się po zatwierdzeniu i najlepiej na dokładnie tym artefakcie planu. Sam plan może się zdezaktualizować, jeśli ktoś w międzyczasie zmieni infrastrukturę ręcznie.
Po co potrzebny jest plik stanu
Plik stanu nie jest zwykłym logiem. Przechowuje mapowanie między deklaracją w kodzie a konkretnym zasobem w chmurze, na przykład identyfikatorem instancji albo nazwą sieci. Bez niego narzędzie miałoby problem z rozpoznaniem, czy ma zaktualizować istniejący obiekt, czy utworzyć kolejny.
W małym eksperymencie lokalny plik terraform.tfstate może wystarczyć. W zespole powinien trafić do zdalnego backendu z szyfrowaniem, kontrolą dostępu i blokadą stanu. Blokada zapobiega równoczesnemu zapisowi dwóch procesów, który mógłby uszkodzić stan albo doprowadzić do nieprzewidywalnych zmian.
Najpopularniejsze narzędzia i różnice między nimi
Nie ma jednego najlepszego narzędzia dla każdego zespołu. Najrozsądniejszy wybór zależy od dostawcy chmury, liczby usług, kompetencji zespołu, wymagań licencyjnych i tego, czy infrastruktura ma być zarządzana w jednym ekosystemie.
| Narzędzie | Najlepsze zastosowanie | Mocna strona | Ograniczenie |
|---|---|---|---|
| Terraform | Wiele chmur i usług | Duży ekosystem providerów i dojrzały workflow plan/apply | Wymaga zrozumienia stanu, modułów i zależności |
| OpenTofu | Projekty potrzebujące otwartego modelu rozwoju | Znany język konfiguracji i kompatybilny styl pracy z Terraformem | Trzeba sprawdzić zgodność providerów oraz używanych funkcji |
| CloudFormation | Środowiska oparte głównie na AWS | Bezpośrednia integracja z usługami AWS i natywne mechanizmy zmian | Mniej wygodny przy zarządzaniu wieloma dostawcami |
| Pulumi | Zespoły preferujące języki programowania | Możliwość używania między innymi Pythona, TypeScriptu i Go | Większa elastyczność ułatwia też tworzenie zbyt złożonego kodu |
Terraform pozostaje praktycznym wyborem, gdy aplikacja korzysta z AWS, Azure, Google Cloud, Cloudflare czy usług zewnętrznych. OpenTofu jest interesującą alternatywą dla zespołów, które chcą oprzeć workflow na projekcie rozwijanym w modelu open source. Nie wybierałbym jednak narzędzia wyłącznie na podstawie popularności. Dostępność dobrego providera i jakość dokumentacji są często ważniejsze niż sama nazwa produktu.
CloudFormation ma sens w organizacji mocno związanej z AWS, szczególnie gdy potrzebne są natywne mechanizmy, takie jak change sets, StackSets czy integracja z kontrolą dostępu AWS. Z kolei Pulumi może spodobać się programistom Pythona, ale należy pilnować, żeby logika aplikacyjna nie zamieniła konfiguracji infrastruktury w trudny do testowania program.
Jak wdrożyć IaC w projekcie backendowym
Na początek nie opisywałbym całej firmy ani wszystkich kont chmurowych. Lepiej wziąć jedną usługę, na przykład backend FastAPI, i zbudować dla niej małe, kompletne środowisko obejmujące sieć, bazę danych, logowanie oraz sposób wdrożenia.
Przykładowy układ repozytorium
infra/
  modules/
    network/
    database/
    service/
  environments/
    dev/
      main.tf
      variables.tf
      outputs.tf
    staging/
    production/
  versions.tf
  backend.tf
Moduł powinien grupować powtarzalny element, a nie każdą pojedynczą linię kodu. Moduł sieciowy może tworzyć VPC, podsieci i routing, natomiast moduł usługi może opisywać klaster, deployment oraz alarmy. Zbyt drobne moduły zwiększają liczbę zależności i utrudniają zrozumienie całości.
Najczęściej utrzymuję osobny stan dla dev, staging i production. Dzięki temu przypadkowa zmiana w środowisku testowym nie miesza się ze stanem produkcji. W mniejszych projektach można użyć workspace’ów, ale przy krytycznych systemach osobne katalogi, uprawnienia i backendy dają czytelniejszą granicę bezpieczeństwa.
Przykład zasobu
variable "service_name" {
  type        = string
  description = "Nazwa usługi backendowej"
}

resource "aws_s3_bucket" "logs" {
  bucket = "${var.service_name}-logs"

  tags = {
    ManagedBy = "terraform"
    Service   = var.service_name
  }
}
Sam zasób jest prosty, lecz produkcyjna konfiguracja powinna uwzględniać szyfrowanie, wersjonowanie, blokadę publicznego dostępu, retencję oraz uprawnienia. To dobry przykład różnicy między „kod działa” a infrastruktura jest gotowa do bezpiecznego użycia.
W pipeline CI warto uruchomić formatowanie, walidację, skanowanie sekretów, analizę bezpieczeństwa i plan. Apply dla produkcji powinien wymagać zatwierdzenia przez osobę lub grupę z odpowiednimi uprawnieniami. Automatyczne -auto-approve może być wygodne, ale bez kontroli procesu łatwo zamienić szybkość w kosztowny incydent.
Co IaC daje zespołowi, a czego nie rozwiązuje
Największa korzyść to odtwarzalność. Nowy programista może uruchomić środowisko z tych samych plików, a zespół może odtworzyć podstawową topologię po awarii lub przygotować drugie środowisko bez ręcznego przepisywania ustawień.
- Powtarzalność ogranicza różnice między środowiskami.
- Historia zmian pokazuje, kto i dlaczego zmienił konfigurację.
- Review pozwala wychwycić ryzykowną regułę przed wdrożeniem.
- Automatyzacja skraca przygotowanie środowiska i ogranicza liczbę czynności ręcznych.
- Standaryzacja ułatwia narzucenie tagów, szyfrowania i minimalnych uprawnień.
Nie oznacza to, że kod sam zapewni wysoką dostępność, niskie koszty albo bezpieczeństwo. Można bardzo elegancko opisać źle zaprojektowaną sieć, zbyt szerokie uprawnienia i bazę bez kopii zapasowych. IaC zwiększa kontrolę, ale nie zastępuje architektury, monitoringu ani kompetencji operacyjnych.
Nie usuwa też wszystkich ręcznych działań. Migracja danych, akceptacja zmiany DNS czy reakcja na awarię mogą wymagać decyzji człowieka. Dobrze opisany proces wyraźnie oddziela czynności automatyzowalne od tych, które powinny pozostać kontrolowane.
Najczęstsze błędy w kodzie infrastruktury
Traktowanie stanu jak zwykłego pliku projektu
Stan może zawierać hasła, tokeny, adresy prywatne i inne dane wrażliwe. Nie powinien trafiać do publicznego repozytorium ani być przesyłany przez komunikator. Używam zdalnego, szyfrowanego storage’u, ograniczam dostęp i włączam wersjonowanie, żeby można było odtworzyć wcześniejszy snapshot.
Ręczne zmiany poza workflow
Tak zwany drift powstaje wtedy, gdy ktoś zmienia zasób w panelu, lecz nie aktualizuje kodu. Czasem jest to uzasadnione podczas awarii, ale później trzeba przenieść zmianę do konfiguracji albo świadomie przywrócić stan opisany w repozytorium. Panel chmurowy nie powinien być drugim źródłem prawdy.
Brak wersjonowania providerów i modułów
Aktualizacja providera może zmienić sposób interpretacji parametrów lub planowane zachowanie zasobu. W repozytorium warto przypinać wersje narzędzia i providerów oraz przechowywać plik blokady zależności. Aktualizacje lepiej wykonywać osobnym pull requestem, z planem i testem.
Zbyt szerokie uprawnienia pipeline’u
Proces wdrożeniowy nie powinien otrzymywać pełnego dostępu do całej organizacji, jeśli modyfikuje tylko jedną aplikację. Rozdzielam konta dla odczytu i zapisu, stosuję krótkotrwałe poświadczenia oraz ograniczam zakres do konkretnego konta, projektu lub środowiska.
Przeczytaj również: API first - Szybciej, lepiej, bez błędów? Sprawdź, jak!
Brak ochrony zasobów krytycznych
Usunięcie produkcyjnej bazy albo głównego bucketa może pojawić się w planie jako pozornie zwykła zmiana. Dla danych używam kopii zapasowych, ochrony przed przypadkowym usunięciem i dodatkowej akceptacji. Przed każdym apply sprawdzam szczególnie linie oznaczone jako destroy lub replace.
Jak zacząć bez budowania zbyt skomplikowanej platformy
Najlepszy pierwszy projekt to środowisko, które można zrozumieć w jeden wieczór. Dla aplikacji backendowej wystarczy na początek sieć, jedna usługa uruchomieniowa, baza, magazyn logów i podstawowe alarmy. Dopiero gdy ten model działa stabilnie, dodawałbym moduły, wiele regionów i bardziej rozbudowaną orkiestrację.
- Wybierz jeden dostawca i jedno środowisko testowe.
- Opisz zasoby w repozytorium i dodaj je do Git.
- Skonfiguruj zdalny stan oraz blokadę operacji.
- Uruchom walidację i plan w CI przy każdym pull requeście.
- Dodaj ochronę sekretów, minimalne uprawnienia i skanowanie konfiguracji.
- Przygotuj procedurę odtworzenia środowiska oraz usuwania zasobów.
Nie zaczynałbym od Kubernetes tylko dlatego, że pojawia się w ogłoszeniach DevOps. Jeśli aplikacja działa na jednej maszynie wirtualnej albo w zarządzanej usłudze kontenerowej, prostsza architektura może być tańsza i łatwiejsza do utrzymania. Dobre IaC upraszcza decyzje, zamiast ukrywać je pod warstwą abstrakcji.
Jeśli pracujesz z Pythonem, możesz użyć Pulumi do opisywania zasobów w tym samym języku co część narzędzi backendowych. Mimo to nie mieszałbym bez potrzeby kodu aplikacji z kodem infrastruktury. Osobne repozytorium lub wyraźne katalogi zwykle ułatwiają uprawnienia, testowanie i odpowiedzialność zespołów.
Od plików konfiguracyjnych do przewidywalnych wdrożeń
Największą wartość daje nie sam wybór Terraformu, OpenTofu czy innego narzędzia, lecz konsekwentny proces. Kod powinien być wersjonowany, plan czytelny dla recenzenta, stan chroniony, a produkcyjne zmiany wykonywane z kontrolą i możliwością wycofania.
Jeśli środowisko jest małe, zacznij od kilku zasobów i dobrze opisanych zmiennych. Jeśli rośnie, podziel konfigurację według własności i cyklu życia, dodaj moduły oraz osobne stany. W ten sposób zarządzanie infrastrukturą przestaje być zbiorem ręcznych sztuczek, a staje się przewidywalną częścią tworzenia i utrzymywania backendu.