Gdy system przestaje mieścić się w jednym procesie, a każda nowa funkcja wymaga dopinania kolejnych bezpośrednich wywołań API, architektura szybko zaczyna przypominać pajęczynę. Podejście event driven development porządkuje ten problem, ponieważ przepływ aplikacji opiera na zdarzeniach, a nie wyłącznie na synchronicznych żądaniach. Pokażę, jak działa ten model, gdzie sprawdza się w backendzie i DevOps, jak wykorzystać go w Pythonie oraz z jakimi kompromisami trzeba się liczyć.
Architektura sterowana zdarzeniami upraszcza komunikację, ale wymaga dyscypliny operacyjnej
- Zdarzenie opisuje fakt, który już nastąpił, na przykład utworzenie zamówienia.
- Producent i konsument mogą działać niezależnie dzięki brokerowi wiadomości.
- Asynchroniczność poprawia skalowanie i odporność, lecz utrudnia śledzenie błędów.
- Idempotencja, retry i DLQ są konieczne, gdy wiadomość może zostać dostarczona więcej niż raz.
- Python dobrze pasuje do konsumentów zdarzeń, zadań asynchronicznych i usług integracyjnych.
Na czym polega programowanie sterowane zdarzeniami
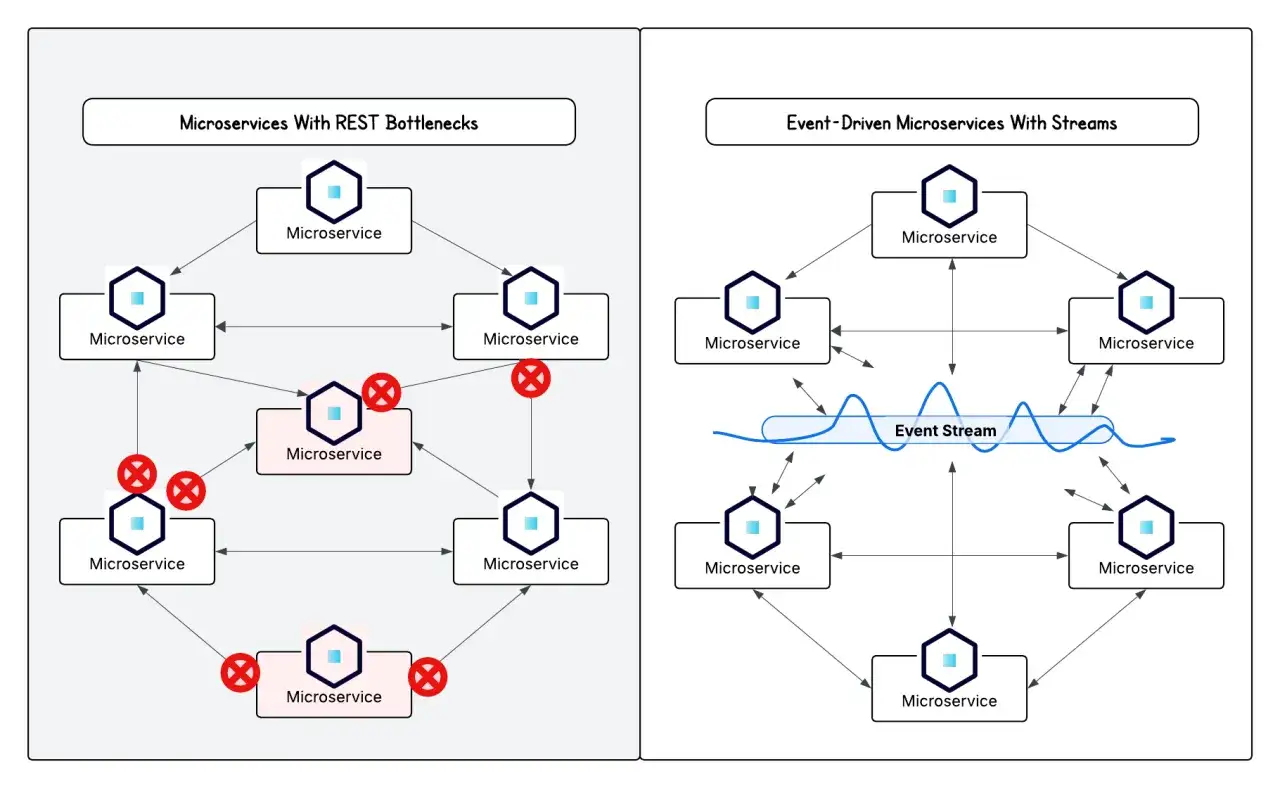
W klasycznym modelu przepływ jest łatwy do odczytania. Serwis zamówień wywołuje magazyn, magazyn odpowiada, a potem serwis płatności wykonuje kolejne żądanie. W architekturze zdarzeniowej serwis publikuje komunikat OrderPlaced, czyli informację, że zamówienie zostało złożone, a zainteresowane komponenty reagują na niego niezależnie.
Najważniejsza zmiana polega na rozdzieleniu faktu od reakcji. Producent nie musi wiedzieć, czy zdarzenie obsłuży magazyn, system mailingowy, analityka czy moduł antyfraudowy. Dzięki temu dodanie nowego konsumenta zwykle nie wymaga modyfikowania kodu producenta, choć wymaga dobrego kontraktu danych i kontroli całego przepływu.
Trzy elementy przepływu
- Producent publikuje zdarzenie po zajściu określonego faktu.
- Broker lub event bus przyjmuje, przechowuje i kieruje komunikaty do odbiorców.
- Konsument odczytuje zdarzenie i wykonuje własną logikę biznesową.
Brokerem może być między innymi Apache Kafka, RabbitMQ, NATS, Redis Streams albo usługa chmurowa taka jak Amazon EventBridge. Nie są to zamienne narzędzia. Kafka jest szczególnie przydatna przy trwałych strumieniach i dużym wolumenie, RabbitMQ dobrze pasuje do kolejek z potwierdzeniami, a EventBridge upraszcza routing zdarzeń w środowisku AWS.
Zdarzenie nie jest poleceniem
To rozróżnienie często decyduje o jakości projektu. Event opisuje przeszłość, na przykład „płatność została zaakceptowana”. Command wyraża zamiar, czyli „zaakceptuj płatność”. Nazwanie komunikatu zgodnie z jego znaczeniem ogranicza nieporozumienia i pomaga później budować czytelne logi oraz metryki.
W praktyce zdarzenie powinno mieć stabilny typ, identyfikator, czas wystąpienia, wersję schematu i dane potrzebne konsumentowi. Przykładowy payload może wyglądać tak:
{
  "id": "evt_8f31",
  "type": "OrderPlaced",
  "version": 1,
  "occurred_at": "2026-08-18T10:15:00Z",
  "payload": {
    "order_id": "ord_2048",
    "customer_id": "cus_91",
    "total": 249.99
  }
}
Nie przesyłam w zdarzeniu całej bazy danych ani danych, które nie są potrzebne odbiorcy. Mały, stabilny kontrakt łatwiej wersjonować, testować i udostępniać wielu zespołom.
Co zyskuje backend, a co traci względem REST
Największą korzyścią jest luźne powiązanie usług. Serwis zamówień może szybko potwierdzić przyjęcie operacji, a dalsze czynności, takie jak rezerwacja produktu lub wysłanie e-maila, wykonać w tle. Przy dużym ruchu konsumenci mogą być skalowani niezależnie, zamiast zmuszać cały łańcuch wywołań do pracy z tą samą intensywnością.
Nie oznacza to jednak, że komunikacja zdarzeniowa zawsze wygrywa z REST. Dla prostego panelu administracyjnego, odczytu profilu albo walidacji wymagającej natychmiastowej odpowiedzi synchroniczne API bywa czytelniejsze i tańsze w utrzymaniu.
| Kryterium | REST i wywołania synchroniczne | Model zdarzeniowy |
|---|---|---|
| Odpowiedź | Zwykle natychmiastowa | Często asynchroniczna |
| Powiązanie usług | Wywołujący zna adres i kontrakt odbiorcy | Producent może nie znać konsumentów |
| Odporność na chwilową awarię | Wymaga timeoutów i mechanizmów zastępczych | Kolejka może przechować pracę do ponowienia |
| Skalowanie | Skaluje się obsługę żądań | Można skalować poszczególnych konsumentów |
| Debugowanie | Zwykle prostsze | Wymaga trace’ów i korelacji zdarzeń |
W systemach produkcyjnych najczęściej sprawdza się hybrydowy model. REST obsługuje żądania, w których użytkownik oczekuje odpowiedzi, a zdarzenia uruchamiają procesy poboczne, integracje i przetwarzanie o większym opóźnieniu.
Przykład z platformy e-commerce
Po złożeniu zamówienia API zwraca klientowi identyfikator oraz status „przyjęte”. Serwis publikuje zdarzenie, a osobni konsumenci zajmują się płatnością, magazynem, powiadomieniem i raportowaniem. Jeśli system e-mailowy przestanie działać, nie musi blokować przyjmowania nowych zamówień.
Ten wzorzec jest sensowny wtedy, gdy użytkownik akceptuje krótkie opóźnienie. Nie zastosowałbym go bezpośrednio do operacji, która musi zakończyć się przed udzieleniem odpowiedzi, na przykład do sprawdzenia limitu kredytowego w krytycznym kroku transakcji.
Jak wdrożyć ten model w Pythonie
W Pythonie można zacząć od prostego lokalnego event busa, a dopiero później podłączyć zewnętrzny broker. Taki prototyp dobrze pokazuje mechanikę, ale nie zapewnia trwałości po restarcie procesu. W środowisku produkcyjnym potrzebne będą jeszcze potwierdzenia, retry, monitoring i przechowywanie komunikatów.
import asyncio
from collections import defaultdict

handlers = defaultdict(list)

def subscribe(event_type, handler):
    handlers[event_type].append(handler)

async def publish(event):
    tasks = [
        handler(event)
        for handler in handlers[event["type"]]
    ]
    await asyncio.gather(*tasks)

async def reserve_stock(event):
    print(f"Rezerwuję produkty dla {event['order_id']}")

async def send_confirmation(event):
    print(f"Wysyłam potwierdzenie dla {event['order_id']}")

subscribe("OrderPlaced", reserve_stock)
subscribe("OrderPlaced", send_confirmation)
W prawdziwej usłudze konsument powinien być odporny na powtórzenia. Jeśli proces zapisze rezerwację, ale ulegnie awarii przed potwierdzeniem wiadomości, broker może dostarczyć ją ponownie. Dlatego przechowuję event_id lub klucz biznesowy i sprawdzam, czy dana operacja nie została już wykonana.
Outbox rozwiązuje problem utraconego zdarzenia
Typowy błąd wygląda tak: aplikacja zapisuje zamówienie w PostgreSQL, a chwilę później próbuje wysłać zdarzenie do brokera. Jeśli proces zakończy się pomiędzy tymi operacjami, zamówienie istnieje, ale reszta systemu nigdy się o nim nie dowie.
Wzorzec Transactional Outbox zapisuje dane biznesowe i oczekujące zdarzenie w jednej transakcji bazodanowej. Osobny worker odczytuje tabelę outbox i publikuje komunikaty. To dodatkowy komponent, ale w krytycznych procesach daje znacznie większą pewność niż liczenie na idealny moment między dwoma niezależnymi zapisami.
Dobór narzędzia do potrzeb
- RabbitMQ wybieram do klasycznych kolejek z routingiem, potwierdzeniami i zadaniami roboczymi.
- Kafka ma sens przy dużych strumieniach, wielu konsumentach oraz potrzebie ponownego odczytu historii.
- NATS pasuje do lekkiej komunikacji o niskich opóźnieniach, zwłaszcza w środowisku usługowym.
- Redis Streams może być praktycznym wyborem dla mniejszych systemów, które i tak korzystają z Redis.
Nie zaczynałbym od wyboru brokera. Najpierw określam, czy potrzebuję trwałej historii, jak długo komunikaty mają być przechowywane, jaka utrata danych jest dopuszczalna i ile niezależnych zespołów będzie konsumować zdarzenia.
Niezawodność wymaga retry, idempotencji i kontroli kolejności
Asynchroniczność nie usuwa błędów, tylko przenosi je w czasie. Konsument może być niedostępny, zewnętrzne API może zwrócić błąd, a komunikat może przyjść ponownie albo w innej kolejności. Dlatego projektuję obsługę awarii zanim dodam pierwszy topic czy queue.
Trzy poziomy dostarczenia
- At most once oznacza, że wiadomość może zginąć, ale nie powinna być przetworzona ponownie.
- At least once chroni przed utratą, lecz dopuszcza duplikaty. To częsty i rozsądny wybór produkcyjny.
- Exactly once jest możliwe tylko w określonym zakresie i wymaga wsparcia całego łańcucha, a nie samego brokera.
Hasło „exactly once” bywa nadużywane. Nawet jeśli broker zapewnia transakcyjne przetwarzanie, efekt uboczny w zewnętrznym systemie, takim jak operator płatności, może wymagać osobnego klucza idempotencji.
Retry i dead-letter queue
Retry powinno mieć limit prób i rosnące opóźnienie, na przykład 1 minuta, 5 minut i 30 minut. Ponawianie bez końca może zablokować kolejkę i ukryć problem zamiast go rozwiązać.
Po przekroczeniu limitu komunikat trafia do dead-letter queue, czyli miejsca dla wiadomości wymagających analizy. Zespół powinien mieć procedurę ponownego odtworzenia takiego zdarzenia po usunięciu przyczyny błędu.
Kolejność nie jest globalna
W rozproszonym systemie nie zakładam, że wszystkie zdarzenia dotrą w kolejności ich wystąpienia. Jeśli kolejność ma znaczenie dla jednego zamówienia, używam stabilnego klucza partycjonowania, na przykład order_id, oraz sprawdzam numer wersji lub numer sekwencyjny zdarzenia.
Dokumentacja Apache Kafka opisuje kolejność na poziomie pojedynczej partycji, a nie całego klastra. To dobry przykład zasady, którą trzeba rozumieć operacyjnie, zamiast opierać projekt na skrócie myślowym „broker zachowa kolejność”.
DevOps musi widzieć przepływ, nie tylko pojedynczy serwis
W architekturze zdarzeniowej pojedynczy status HTTP nie mówi całej prawdy o procesie. Żądanie może zakończyć się poprawnie, ale konsument może przetworzyć zdarzenie dopiero po kilkunastu sekundach. Bez obserwowalności zespół nie odróżni normalnego opóźnienia od awarii.
Każde zdarzenie powinno mieć correlation_id oraz identyfikator śladu rozproszonego. Logi producenta, brokera i konsumenta muszą pozwalać połączyć jeden proces biznesowy od wejściowego żądania aż do końcowego efektu.
Przeczytaj również: Co to jest klasyczny ASP? Działanie, DevOps i kiedy migrować
Metryki, które naprawdę pomagają
- Lag konsumenta, czyli różnica między najnowszym zdarzeniem a miejscem odczytu.
- Wiek najstarszej wiadomości oczekującej w kolejce.
- Odsetek błędów i retry dla każdego typu zdarzenia.
- Liczba wiadomości w DLQ oraz czas ich przebywania poza głównym przepływem.
- Opóźnienie end-to-end od publikacji do zakończenia obsługi.
W pipeline CI/CD testuję nie tylko kod konsumenta, lecz także kompatybilność schematów. Zmiana nazwy pola lub jego typu może zepsuć kilka usług, nawet jeśli ich repozytoria budują się niezależnie. Przydatne są testy kontraktowe, wersjonowanie schematów i zasada kompatybilności wstecznej.
Wdrożenia powinny uwzględniać możliwość chwilowego współistnienia starego i nowego konsumenta. Najbezpieczniej dodawać pola opcjonalne, wdrażać producenta oraz odbiorców etapami i obserwować lag oraz błędy przed usunięciem starej wersji.
Kiedy architektura zdarzeniowa jest dobrym wyborem
Najlepszym kandydatem jest system, w którym wiele niezależnych reakcji wynika z jednego faktu biznesowego. Przykładami są zamówienia, płatności, telemetria, integracje z partnerami, powiadomienia i przetwarzanie danych w czasie rzeczywistym.
Nie budowałbym całego małego CRUD-a na Kafka tylko dlatego, że brzmi nowocześnie. Koszt poznawczy i operacyjny brokera, schematów, monitoringu oraz obsługi awarii może przewyższyć korzyść z luźnego powiązania.
| Sytuacja | Rekomendowane podejście | Powód |
|---|---|---|
| Jedna aplikacja i kilka prostych operacji | Modułowy monolit | Mniej infrastruktury i prostsze debugowanie |
| Wiele usług reagujących na jedno zdarzenie | Pub/sub lub event bus | Niezależne skalowanie i łatwiejsze dodawanie konsumentów |
| Duży strumień danych i analityka w czasie rzeczywistym | Platforma event streamingowa | Trwałość, partycjonowanie i możliwość ponownego odczytu |
| Operacja wymagająca natychmiastowej odpowiedzi | REST lub gRPC | Wyraźny kontrakt żądanie-odpowiedź |
Moja praktyczna zasada jest prosta. Najpierw rozdzielam moduły i ustalam granice odpowiedzialności, a dopiero później wprowadzam komunikację asynchroniczną tam, gdzie naprawdę redukuje zależności. Broker nie naprawi złego modelu domeny i nie zastąpi jasnych kontraktów między zespołami.
Największą przewagę daje dobrze zaprojektowany kontrakt zdarzenia
Programowanie sterowane zdarzeniami najlepiej działa wtedy, gdy zespół potrafi odpowiedzieć na kilka praktycznych pytań. Co dokładnie oznacza zdarzenie, kto jest jego właścicielem, jak długo pozostaje ważne, czy można je odtworzyć i co dzieje się po częściowej awarii?
Na start wystarczy jeden konkretny proces, na przykład publikacja OrderPlaced i dwóch konsumentów. Dołóż wersjonowanie schematu, idempotencję, ograniczone retry, DLQ oraz podstawowe metryki. Dopiero gdy przepływ jest stabilny, warto rozszerzać go o kolejne usługi i przetwarzanie strumieniowe.
W Pythonie ten model daje dużą swobodę, szczególnie przy usługach opartych na asyncio, workerach i integracjach. Najważniejsza decyzja nie dotyczy jednak biblioteki, lecz tego, czy opóźnienie, eventual consistency i dodatkowa złożoność są uczciwą ceną za skalowanie oraz niezależność komponentów.