Gdy jeden zakup uruchamia płatność, rezerwację magazynową, wiadomość e-mail i aktualizację analityki, pojedyncze wywołanie REST szybko zaczyna łączyć ze sobą zbyt wiele usług. Termin event driven architecture opisuje podejście, w którym system reaguje na fakty biznesowe zapisane jako zdarzenia, zamiast stale pytać inne komponenty o ich stan. Wyjaśniam, jak działa ten model, jakie daje korzyści w backendzie i DevOps, jak dobrać brokera oraz gdzie pojawiają się realne koszty i ryzyka.
Architektura zdarzeniowa upraszcza komunikację, ale wymaga dyscypliny
- Producent publikuje informację o zdarzeniu, a konsumenci reagują na nią niezależnie.
- Broker wiadomości pośredniczy w komunikacji i pozwala skalować usługi bez tworzenia wielu bezpośrednich zależności.
- Asynchroniczność poprawia odporność i przepustowość, lecz oznacza opóźnienia oraz eventual consistency.
- Idempotencja, retry i kolejka DLQ są podstawą bezpiecznej obsługi błędów.
- Kafka, RabbitMQ i usługi chmurowe rozwiązują podobne problemy, ale pasują do innych przepływów danych.
Jak działa architektura oparta na zdarzeniach
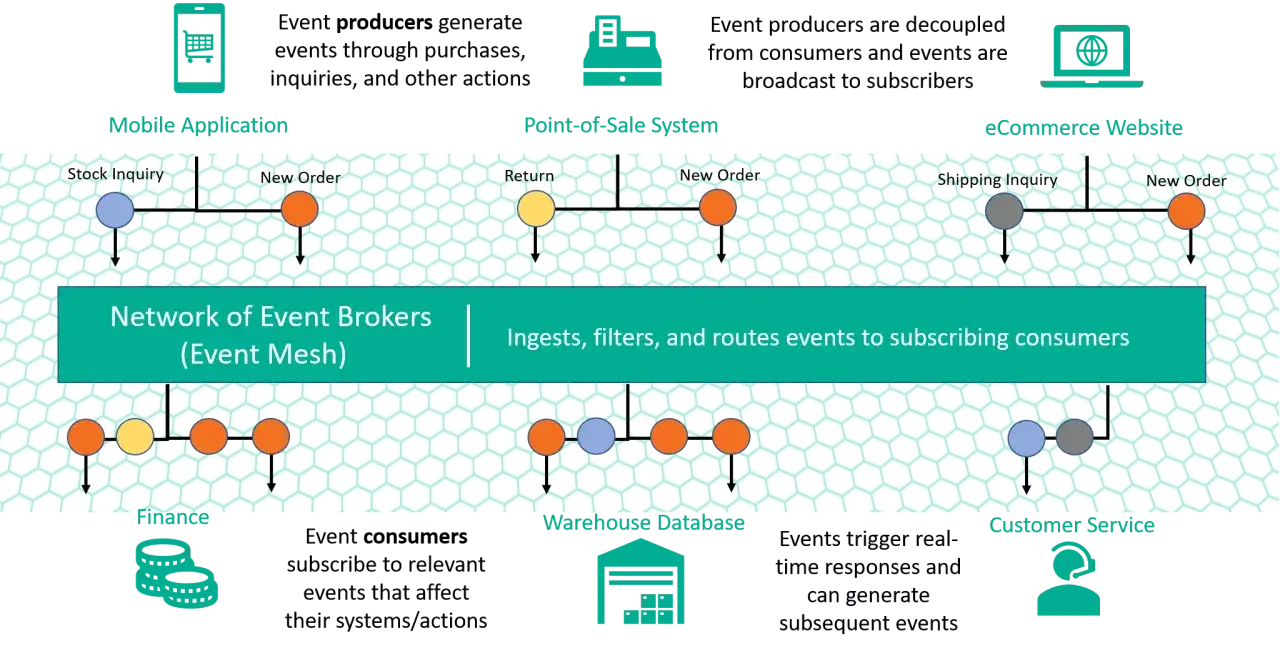
W klasycznym modelu żądanie przechodzi synchronicznie z jednej usługi do drugiej. Serwis zamówień wywołuje płatności, płatności kontaktują się z magazynem, a na końcu ktoś wysyła e-mail. W modelu zdarzeniowym serwis zamówień publikuje fakt OrderPlaced, a zainteresowane komponenty same decydują, co z nim zrobią.
W przepływie występują trzy podstawowe role. Producent wykrywa zmianę i publikuje komunikat, broker przechowuje go oraz przekazuje dalej, a konsument wykonuje reakcję, na przykład pobiera płatność lub zmniejsza stan magazynowy.
| Element | Odpowiedzialność | Przykład |
|---|---|---|
| Producent | Publikuje zdarzenie po zmianie stanu | Serwis zamówień |
| Broker | Routuje, buforuje i dostarcza komunikaty | Kafka, RabbitMQ, NATS |
| Konsument | Reaguje na zdarzenie i wykonuje własną logikę | Serwis płatności |
Zdarzenie nie jest tym samym co polecenie
Zdarzenie opisuje coś, co już się wydarzyło, na przykład InvoiceIssued albo UserRegistered. Polecenie wyraża intencję wykonania operacji, taką jak „zarezerwuj produkt”. To rozróżnienie ma znaczenie, bo odbiorca polecenia powinien je wykonać, natomiast odbiorca zdarzenia może je zignorować, jeśli nie należy ono do jego odpowiedzialności.
Unikam nazywania poleceń zdarzeniami. Nazwa SendWelcomeEmail sugeruje konkretną instrukcję i silniej wiąże nadawcę z odbiorcą. Nazwa UserRegistered opisuje fakt, dzięki czemu później można dodać analitykę, system rabatowy albo integrację z CRM bez modyfikowania serwisu użytkowników.
Broker, kolejka i temat
Broker może działać jako event bus, kolejka albo trwały dziennik zdarzeń. W modelu pub/sub wielu konsumentów otrzymuje własną kopię komunikatu, natomiast w kolejce kilku pracowników konkuruje o te same zadania. Temat lub topic to logiczny kanał, do którego producent publikuje zdarzenia, a konsumenci zakładają subskrypcje.
Przykładowy przepływ dla sklepu wygląda tak:
Order Service
    |
    | OrderPlaced
    v
Event Broker
    |------------> Payment Service
    |------------> Warehouse Service
    |------------> Notification Service
Najważniejsza cecha tego układu to luźne powiązanie. Producent nie musi znać listy odbiorców, a nowy konsument można wdrożyć bez przebudowy istniejącego serwisu. Nie oznacza to jednak braku zależności. Zależność przenosi się z kodu wywołującego na kontrakt zdarzenia, jego semantykę i zasady dostarczania.
Co ten model zmienia w backendzie i DevOps
Największą korzyścią jest możliwość niezależnego skalowania poszczególnych etapów. Jeżeli w poniedziałek rano rośnie liczba zamówień, można zwiększyć liczbę konsumentów płatności lub magazynu, bez uruchamiania dodatkowych instancji całej aplikacji. Broker działa wtedy jak bufor między producentem a pracownikami.
Asynchroniczna komunikacja ogranicza również wpływ chwilowej awarii. Serwis zamówień może przyjąć operację, a wiadomość czeka w kolejce na przywrócenie usługi płatniczej. Cena za tę odporność jest konkretna: użytkownik nie zawsze otrzyma końcowy rezultat natychmiast, a system musi pokazywać status typu „przetwarzanie w toku”.
Skalowanie nie oznacza automatycznie niskich opóźnień
Architektura zdarzeniowa dobrze radzi sobie z dużą liczbą niezależnych zadań, lecz nie rozwiązuje każdego problemu wydajnościowego. Jeżeli proces wymaga pięciu kolejnych reakcji, opóźnienie może być sumą czasu przetwarzania wszystkich konsumentów. Przy operacjach wymagających natychmiastowej odpowiedzi nadal lepsze bywa synchroniczne API.
W praktyce mierzę nie tylko czas odpowiedzi HTTP, ale też consumer lag, czyli opóźnienie między pojawieniem się zdarzenia a jego obsłużeniem. Dla procesu ważnego biznesowo przydatne są również liczba ponowień, wiek najstarszej wiadomości, odsetek błędów oraz czas od zdarzenia początkowego do końcowej zmiany statusu.
DevOps musi obsługiwać przepływ, nie tylko kontenery
Wdrożenie usługi konsumującej zdarzenia wymaga więcej niż obrazu Dockera i manifestu Kubernetes. Trzeba kontrolować kontrakty komunikatów, uprawnienia do tematów, retencję, monitoring i procedury odtwarzania. Bez tego awaria pojedynczego konsumenta może pozostać niewidoczna, choć wiadomości będą narastać przez wiele godzin.
Pipeline CI/CD powinien sprawdzać zgodność schematu zdarzeń oraz uruchamiać testy integracyjne z brokerem. Przy zmianach niekompatybilnych wstecznie bezpieczniejszy jest model „najpierw dodaj nowe pole, potem migruj odbiorców, na końcu usuń stare”, a nie jednoczesna zmiana wszystkich usług.
Kafka, RabbitMQ czy broker chmurowy
Nie wybieram narzędzia od nazwy technologii, tylko od rodzaju komunikacji. Innych właściwości potrzebuje strumień milionów zdarzeń analizowanych przez wiele zespołów, a innych kolejka zadań, które mają zostać wykonane dokładnie przez jednego pracownika.
| Rozwiązanie | Najlepsze zastosowanie | Mocne strony | Ograniczenia |
|---|---|---|---|
| Apache Kafka | Duże strumienie i historia zdarzeń | Wysoka przepustowość, partycje, odczyt z wybranego miejsca | Większy narzut operacyjny i trudniejsza konfiguracja |
| RabbitMQ | Kolejki zadań i routowanie komunikatów | Elastyczne routing keys, potwierdzenia, prosty model kolejki | Mniej naturalny wybór dla bardzo dużych, długotrwałych strumieni |
| NATS | Lekka komunikacja między usługami | Niskie opóźnienia i prostota uruchomienia | Dobór trwałości i historii wymaga świadomej konfiguracji |
| Broker chmurowy | Integracje i systemy bez własnego zespołu platformowego | Skalowanie, monitoring i HA częściowo po stronie dostawcy | Koszt zależny od ruchu oraz ryzyko uzależnienia od dostawcy |
Kafka pasuje do event streamingu, gdy zdarzenia mają być dostępne przez określony czas i mogą zostać odczytane ponownie. To dobry fundament dla analityki, integracji danych i wielu niezależnych grup konsumentów. Nie używałbym jej jednak jako domyślnej kolejki do każdego prostego zadania.
RabbitMQ często sprawdza się w backendzie Pythona, gdy aplikacja rozdziela pracę na zadania wykonywane przez workerów. Typowym zestawem jest aplikacja webowa, broker oraz Celery. Zaletą jest czytelny model potwierdzeń i ponowień, ale trwałość, kolejność oraz obsługa duplikatów nadal trzeba zaprojektować samodzielnie.
Usługi takie jak Amazon EventBridge, Google Pub/Sub czy Azure Event Grid ograniczają liczbę czynności administracyjnych. Płaci się za to mniejszą kontrolą nad infrastrukturą, zależnością od konkretnego środowiska i koniecznością pilnowania limitów oraz kosztów transferu. Dla małego zespołu ten kompromis bywa korzystny, szczególnie przy integracjach między usługami.
Jak projektować zdarzenia i bezpieczną obsługę błędów
Dobrze zaprojektowane zdarzenie jest kontraktem między zespołami. Powinno mieć nazwę opisującą fakt, identyfikator, czas wystąpienia, wersję schematu, identyfikator korelacji oraz dane potrzebne konsumentowi. Nie wkładam do payloadu całego obiektu z bazy tylko dlatego, że jest to wygodne na początku.
{
  "event_id": "9f2c...",
  "event_type": "OrderPlaced",
  "event_version": 1,
  "occurred_at": "2026-08-18T10:15:00Z",
  "correlation_id": "a81b...",
  "data": {
    "order_id": "ord-123",
    "customer_id": "cus-456",
    "total": 249.00,
    "currency": "PLN"
  }
}
Idempotencja chroni przed duplikatami
W systemach rozproszonych konsument może otrzymać ten sam komunikat więcej niż raz. Dlatego obsługa musi być idempotentna, czyli wielokrotne przetworzenie tego samego zdarzenia powinno dać taki sam efekt jak przetworzenie go jeden raz.
Najprostszy mechanizm to tabela przetworzonych identyfikatorów zdarzeń z unikalnym indeksem. Konsument sprawdza event_id, wykonuje zmianę w jednej transakcji i zapisuje informację o obsłużeniu. Przy płatnościach potrzebne są dodatkowe zabezpieczenia po stronie dostawcy, ponieważ samo sprawdzenie w aplikacji nie zawsze chroni przed podwójnym obciążeniem.
Outbox rozwiązuje problem dwóch zapisów
Klasyczny błąd wygląda tak: aplikacja zapisuje zamówienie w PostgreSQL, a chwilę później publikuje zdarzenie. Jeśli proces zakończy się pomiędzy tymi operacjami, baza zna zamówienie, ale broker nie wie, że powinien uruchomić dalsze kroki.
Wzorzec transactional outbox zapisuje dane biznesowe i oczekujące zdarzenie w tej samej transakcji. Osobny publisher odczytuje tabelę outbox i wysyła komunikaty do brokera. To nie usuwa wszystkich duplikatów, dlatego konsument nadal musi być idempotentny, ale znacząco zmniejsza ryzyko utraty zdarzenia.
Retry i DLQ muszą mieć granice
Automatyczne ponawianie ma sens przy błędach przejściowych, takich jak chwilowa niedostępność API. Nie pomaga, gdy komunikat jest trwale niepoprawny. Wtedy lepszy jest dead-letter queue, czyli osobna kolejka na wiadomości, których nie udało się przetworzyć po ustalonej liczbie prób.
- stosuj rosnące odstępy między próbami, na przykład 1, 5 i 15 minut,
- oddziel błędy przejściowe od walidacyjnych,
- dodaj limit prób i alarm po przekroczeniu progu,
- zachowuj oryginalny komunikat oraz przyczynę błędu,
- przygotuj bezpieczny proces ponownego odtworzenia wiadomości z DLQ.
Nie obiecuję ścisłej kolejności zdarzeń w całym systemie, bo zwykle jest to kosztowne i ogranicza skalowanie. Jeśli kolejność jest ważna, wiążę zdarzenia z konkretnym kluczem, na przykład order_id, i pilnuję jej tylko w obrębie danego agregatu.
Jak obserwować i wdrażać system zdarzeniowy
Najtrudniejszy moment przychodzi podczas awarii. W logu konsumenta widać wtedy pojedynczy błąd, ale jego przyczyna może znajdować się w serwisie, który opublikował zdarzenie kilkanaście sekund wcześniej. Dlatego każde zdarzenie powinno przenosić correlation_id i najlepiej także trace context zgodny z używanym systemem śledzenia.
Minimalny zestaw metryk
- opóźnienie konsumenta mierzone od publikacji do rozpoczęcia obsługi,
- liczba wiadomości oczekujących w każdej kolejce lub partycji,
- odsetek błędów i ponowień z podziałem na typ zdarzenia,
- czas przetwarzania oraz jego wartości p95 i p99,
- liczba wiadomości w DLQ i wiek najstarszej z nich.
Do tego dochodzą logi strukturalne, dashboard przepływu oraz rozproszone śledzenie żądania. Sam status „broker działa” niczego nie gwarantuje. Broker może przyjmować wiadomości, podczas gdy konsumenci będą nieaktywne albo nie będą mieć dostępu do właściwego tematu.
Przeczytaj również: CI/CD na Kubernetesie - Czy to rozwiązanie dla Twojego backendu?
Testy powinny sprawdzać kontrakty
Test jednostkowy konsumenta nie wystarczy. Potrzebne są contract tests, które sprawdzają, czy producent publikuje dane zgodne z oczekiwaniami odbiorców. Warto również testować duplikaty, zmianę kolejności, opóźnione dostarczenie, niedostępność brokera i ponowne przetwarzanie wiadomości.
Wdrożenie robię etapami. Najpierw uruchamiam nowego konsumenta w trybie obserwacji lub z ograniczonym ruchem, później zwiększam obciążenie i dopiero na końcu usuwam starą ścieżkę synchroniczną. Przy migracji danych przydatne jest odtworzenie zdarzeń na osobnej grupie konsumentów, bez wpływania na produkcyjne przetwarzanie.
Kiedy lepiej wybrać prostsze rozwiązanie
Architektura zdarzeniowa nie jest obowiązkowym etapem dojrzewania aplikacji. Dla małego systemu z jedną bazą, kilkoma endpointami i krótkim zespołem utrzymaniowym broker może dodać więcej pracy niż wartości. W takim przypadku modularny monolit z dobrze rozdzielonymi modułami często daje lepszy stosunek prostoty do możliwości.
| Potrzeba | Lepszy wybór | Dlaczego |
|---|---|---|
| Natychmiastowa odpowiedź dla użytkownika | REST lub gRPC | Łatwiejsze potwierdzenie wyniku operacji |
| Niezależne przetwarzanie wielu reakcji | Pub/sub i broker zdarzeń | Każdy konsument może działać osobno |
| Ciężkie zadania w tle | Kolejka z workerami | Można kontrolować retry i obciążenie |
| Historia zmian i replay | Event streaming lub event sourcing | Zdarzenia pozostają dostępne do ponownego odczytu |
Nie łączyłbym automatycznie tego modelu z mikroserwisami, CQRS i event sourcingiem. Są to osobne decyzje. Można mieć prosty monolit publikujący zdarzenia do kolejki, a można też zbudować rozbudowany system mikroserwisowy bez pełnego event sourcingu.
Największe ryzyko widzę w tak zwanym łańcuchu zdarzeń bez właściciela. Usługa publikuje komunikat, ten uruchamia kolejną usługę, a ta kolejną, lecz nikt nie potrafi szybko odpowiedzieć, gdzie kończy się proces, kto odpowiada za jego wynik i jak go cofnąć. Granice domen, nazwy zdarzeń, dokumentacja i monitoring są ważniejsze niż sama obecność Kafki czy RabbitMQ.
Pierwszy krok powinien być mniejszy niż cała platforma
Najbezpieczniej zacząć od jednego procesu, który rzeczywiście korzysta z asynchroniczności. Dobrym kandydatem jest wysyłka powiadomień, generowanie raportu albo aktualizacja indeksu wyszukiwania. Zachowaj synchroniczną ścieżkę dla operacji wymagających natychmiastowego wyniku, a zdarzeniami obejmij tylko reakcje, które mogą wykonać się chwilę później.
Przed wdrożeniem spisz nazwy zdarzeń, właścicieli, wersje schematów, zasady retry i metryki. Jeśli zespół nie potrafi odtworzyć przepływu na kartce ani wskazać zachowania przy awarii konsumenta, dodatkowa infrastruktura prawdopodobnie pojawiła się zbyt wcześnie.
Dobrze zaprojektowany system zdarzeniowy daje backendowi elastyczność, a zespołom DevOps lepsze możliwości skalowania i izolowania awarii. Jego wartość nie wynika jednak z modnego wzorca, tylko z konsekwentnego modelowania faktów, kontroli błędów i obserwowalności całego przepływu.