Gdy dane tworzą gęstą sieć zależności, zwykły układ plików szybko przestaje wystarczać. W tym materiale wyjaśniam, jak działa sieciowy model przechowywania danych, czym są rekordy, zbiory i wskaźniki oraz dlaczego rozwiązanie popularne przed erą SQL wciąż pojawia się w dokumentacji starszych systemów. Pokazuję też przykład, porównuję ten model z relacyjnymi bazami danych i podpowiadam, kiedy warto go analizować, a kiedy lepiej sięgnąć po inne podejście.
Najważniejsze jest to, że dane są połączone ścieżkami
- Model sieciowy przechowuje rekordy połączone nazwanymi relacjami, a nie wyłącznie w tabelach.
- Jego podstawą są typy rekordów oraz zbiory typu owner-member, czyli właściciel i jego elementy członkowskie.
- Relacje mogą tworzyć graf z wieloma rodzicami, dlatego model jest bardziej elastyczny niż hierarchiczny.
- Dostęp do danych odbywa się nawigacyjnie, często przez wskaźniki i predefiniowane ścieżki.
- Największą zaletą jest szybki odczyt znanych relacji, a największą wadą silne uzależnienie aplikacji od struktury bazy.
- SQL nie jest językiem tego modelu. SQL powstał przede wszystkim dla modelu relacyjnego.
Jak działa model sieciowy bazy danych
Sieciowy model bazy danych opisuje informacje jako rekordy połączone relacjami. Rekord może przechowywać dane klienta, zamówienia, produktu albo pracownika, natomiast relacja mówi, które rekordy są ze sobą powiązane i jak aplikacja ma się między nimi poruszać.
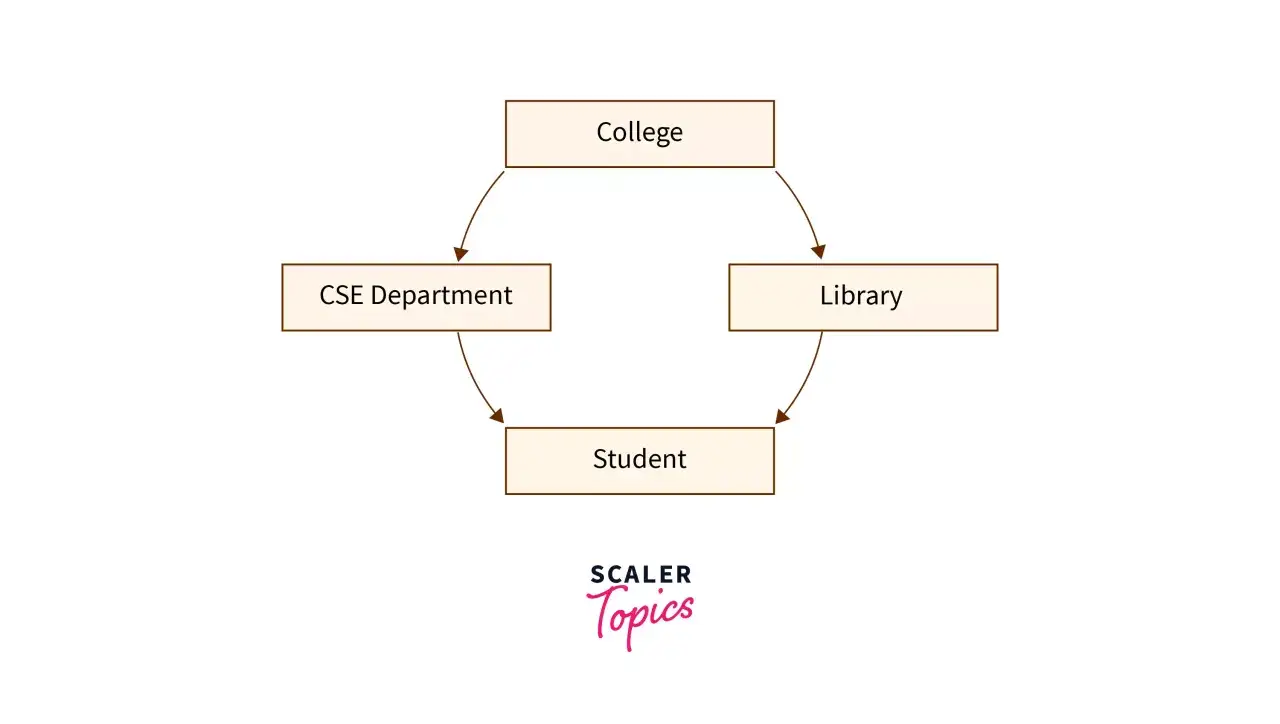
Najczęściej kojarzy się go ze specyfikacją CODASYL DBTG, rozwijaną pod koniec lat 60. i na początku lat 70. XX wieku. Była to odpowiedź na ograniczenia modelu hierarchicznego, w którym dane układały się przede wszystkim w drzewo. W drzewie element ma zwykle jednego rodzica, a w strukturze sieciowej może być powiązany z wieloma innymi elementami.
Dobrą intuicją jest wyobrażenie sobie mapy połączeń. W modelu relacyjnym pytamy bazę, które wiersze spełniają warunek, a silnik sam dobiera sposób wykonania zapytania. W modelu sieciowym program często dostaje rekord startowy i krok po kroku przechodzi po zdefiniowanych połączeniach.
Nawigacja zamiast swobodnego wyszukiwania
To ważna różnica. Aplikacja może rozpocząć od rekordu klienta, przejść do jego zamówień, potem do pozycji zamówienia, a na końcu do produktów. Taka ścieżka jest bardzo szybka, jeśli odpowiada temu, jak zaprojektowano bazę, ale mniej wygodna, gdy użytkownik chce zadać nowe, wcześniej nieprzewidziane pytanie.
Właśnie dlatego nie należy utożsamiać tego podejścia z nowoczesną bazą grafową. Oba modele opisują połączenia, lecz klasyczny model sieciowy opiera się na z góry zdefiniowanych typach rekordów i relacji, a współczesne bazy grafowe zwykle oferują inne języki zapytań, indeksowanie i mechanizmy eksploracji grafu.
Rekordy, zbiory i wskaźniki tworzą jedną strukturę
W klasycznej wersji sieciowej baza składa się z typów rekordów oraz typów zbiorów. Typ rekordu określa pola, które mogą wystąpić w danym obiekcie, natomiast konkretny rekord zawiera już rzeczywiste wartości, na przykład numer klienta, nazwę firmy i adres e-mail.
Najbardziej charakterystycznym elementem jest set type, czyli nazwany zbiór relacji. Ma on rekord właściciela, określany jako owner, oraz jeden lub wiele rekordów członkowskich, czyli members. Przykładowo rekord „Klient” może być właścicielem zbioru „Zamówienia klienta”, a poszczególne zamówienia stają się jego członkami.
| Element | Znaczenie | Przykład |
|---|---|---|
| Typ rekordu | Definicja pól i struktury obiektu | Klient, Produkt, Zamówienie |
| Wystąpienie rekordu | Konkretny obiekt zapisany w bazie | Klient o numerze 1042 |
| Typ zbioru | Zdefiniowane powiązanie między rekordami | Klient - Zamówienia |
| Owner | Rekord nadrzędny w danym powiązaniu | Klient |
| Member | Rekord należący do powiązania | Zamówienie |
| Wskaźnik | Odwołanie do powiązanego rekordu lub kolejnego elementu | Przejście do następnego zamówienia |
Wskaźniki mogą wskazywać na fizyczne położenie rekordu albo na logiczny identyfikator zarządzany przez system. Dla programisty oznacza to możliwość szybkiego przechodzenia po relacji bez przeszukiwania całego zbioru danych. Ceną jest jednak większa zależność od organizacji pamięci i od tego, jak zaprojektowano ścieżki dostępu.
Dlaczego sieć jest elastyczniejsza od drzewa
Ten sam rekord może uczestniczyć w wielu zbiorach. Produkt może należeć do katalogu, pojawiać się w pozycjach zamówień i być przypisany do kilku kampanii promocyjnych. Dzięki temu model dobrze opisuje sytuacje, w których relacje wiele-do-wielu są czymś naturalnym.
W praktyce relacja wiele-do-wielu często wymaga rekordu pośredniego. Dla połączenia „Zamówienie - Produkt” takim rekordem może być „Pozycja zamówienia”, przechowująca również liczbę sztuk i cenę z chwili zakupu. To rozwiązanie przypomina tabelę łącznikową z modelu relacyjnego, ale w modelu sieciowym jest częścią nawigacyjnej struktury powiązań.
Przykład pokazuje, jak aplikacja porusza się po danych
Załóżmy prosty system sprzedażowy z czterema typami rekordów: Klient, Zamówienie, Pozycja i Produkt. Klient ma wiele zamówień, zamówienie ma wiele pozycji, a każda pozycja wskazuje produkt. Produkt może wystąpić w tysiącach różnych zamówień.
Logiczna ścieżka może wyglądać tak:
- odszukaj rekord klienta po jego identyfikatorze,
- przejdź do pierwszego zamówienia należącego do klienta,
- przejdź przez kolejne zamówienia w tym samym zbiorze,
- dla wybranego zamówienia przejdź do jego pozycji,
- z każdej pozycji odczytaj powiązany rekord produktu.
W takim scenariuszu system wykonuje ciąg kontrolowanych przejść. Nie musi łączyć dużych tabel podczas każdego odczytu, ponieważ relacje zostały zapisane wcześniej. To tłumaczy, dlaczego rozwiązania nawigacyjne były atrakcyjne w systemach transakcyjnych, gdzie liczyła się przewidywalna obsługa konkretnych operacji.
Problem pojawia się wtedy, gdy raport wymaga innego kierunku przejścia. Pytanie „które produkty kupili klienci z określonego regionu w ostatnim kwartale?” może wymagać przejścia od regionu do klientów, od klientów do zamówień i dalej do produktów. Jeżeli taka ścieżka nie została dobrze zaplanowana, kod szybko staje się trudny do utrzymania.
Rekord pośredni dla relacji wiele-do-wielu
Warto przyjrzeć się pozycji zamówienia. Nie jest ona wyłącznie technicznym dodatkiem, lecz przechowuje fakty związane z konkretnym powiązaniem, na przykład ilość, cenę i rabat. Ten sam produkt ma inną cenę w różnych zamówieniach, dlatego zapisanie ceny tylko w rekordzie produktu prowadziłoby do utraty historii.
To przykład uniwersalnej zasady modelowania danych. Jeżeli informacja opisuje relację dwóch obiektów, często powinna trafić do osobnego rekordu lub encji pośredniej, a nie do jednego z obiektów końcowych.
Zalety są wyraźne, ale ograniczenia szybko wychodzą na jaw
Największą mocną stroną tego podejścia jest wydajny dostęp po znanej ścieżce. Program nie musi za każdym razem budować skomplikowanego planu wyszukiwania. Jeśli aplikacja regularnie wykonuje te same operacje, bezpośrednie przejście między rekordami może być bardzo skuteczne.
Drugą zaletą jest możliwość odwzorowania bardziej złożonych zależności niż w klasycznym modelu hierarchicznym. Rekord może mieć wielu „rodziców”, a sieć zbiorów pozwala opisywać struktury organizacyjne, katalogi, systemy rezerwacji czy zależności między komponentami.
| Obszar | Korzyść | Ograniczenie |
|---|---|---|
| Odczyt danych | Szybki przy znanej ścieżce | Mniej wygodny przy nowych, ad hoc zapytaniach |
| Relacje | Dobrze obsługuje wiele powiązań | Struktura może stać się trudna do zrozumienia |
| Zmiana schematu | Precyzyjna kontrola nad zapisem | Zmiany często wymagają modyfikacji aplikacji |
| Programowanie | Przewidywalne operacje na rekordach | Kod musi znać sposób nawigacji po bazie |
| Przenośność | Dobre dopasowanie do konkretnego środowiska | Większe uzależnienie od dostawcy i implementacji |
Najpoważniejszą wadą jest sprzężenie aplikacji ze schematem. W relacyjnej bazie zmiana sposobu połączenia tabel często kończy się zmianą zapytań. W modelu nawigacyjnym zmiana zbioru, kolejności rekordów albo ścieżki dostępu może wymagać przebudowy fragmentów programu, ponieważ aplikacja korzysta bezpośrednio z tej organizacji.
Trudniejsze są również raportowanie, integracja z nowymi narzędziami i praca zespołowa. Programista musi rozumieć nie tylko znaczenie danych, ale też sposób, w jaki system pozwala się po nich poruszać. Dla nowych osób w projekcie oznacza to wyższy próg wejścia.
Model sieciowy a relacyjny i SQL
Model relacyjny porządkuje dane w tabelach złożonych z wierszy i kolumn. Relacje opisują klucze, a użytkownik korzysta z deklaratywnego języka SQL, określając jaki wynik chce otrzymać, bez ręcznego wskazywania każdego przejścia między rekordami.
W klasycznym modelu sieciowym dominuje podejście nawigacyjne. Program określa, od którego rekordu zacząć, do którego zbioru wejść i jak przejść do następnego elementu. To dwa różne sposoby myślenia o danych, nawet jeśli oba potrafią opisać podobne zależności.
| Kryterium | Model sieciowy | Model relacyjny |
|---|---|---|
| Podstawowa struktura | Rekordy i nazwane zbiory relacji | Tabele, wiersze i kolumny |
| Sposób dostępu | Nawigacja po ścieżkach | Deklaratywne zapytania SQL |
| Zmiana zapytań | Często wymaga kodu nawigacyjnego | Zwykle wystarczy nowe zapytanie |
| Relacje wiele-do-wielu | Przez zbiory i rekordy pośrednie | Przez klucze i tabele łącznikowe |
| Typowe zastosowanie | Starsze systemy o przewidywalnych ścieżkach | Nowe aplikacje, analityka i integracje |
SQL nie jest więc naturalnym językiem dla pierwotnej wersji tego modelu. Niektóre starsze systemy otrzymały później interfejsy SQL, lecz nie zmieniało to automatycznie ich wewnętrznej organizacji. Z zewnątrz można było używać zapytań podobnych do relacyjnych, podczas gdy pod spodem nadal działała nawigacyjna baza rekordów i wskaźników.
Dla porównania, relacyjny odpowiednik raportu sprzedażowego mógłby wyglądać tak:
SELECT p.nazwa, SUM(pz.ilosc) AS sprzedane_sztuki
FROM pozycje_zamowien pz
JOIN produkty p ON p.id = pz.produkt_id
JOIN zamowienia z ON z.id = pz.zamowienie_id
WHERE z.data_zamowienia >= '2026-01-01'
GROUP BY p.nazwa;
W sieciowym systemie podobny wynik byłby zwykle uzyskiwany przez przejście po rekordach zamówień, pozycji i produktów. SQL jest krótszy i łatwiejszy do zmiany, ale jego wydajność zależy od indeksów, planu wykonania oraz implementacji silnika. Nie można więc sprowadzać porównania do prostego stwierdzenia, że jedno rozwiązanie zawsze jest szybsze.
Kiedy warto znać ten model w 2026 roku
Nowego projektu zazwyczaj nie zaczynałbym od klasycznej bazy CODASYL. Relacyjny model z SQL oferuje dziś lepszą dostępność narzędzi, większy wybór bibliotek dla Pythona, prostsze raportowanie i łatwiejsze pozyskiwanie programistów. Jeżeli dane mają charakter silnie grafowy, można też rozważyć współczesną bazę grafową, ale nie należy mylić jej z historycznym modelem sieciowym.
Znajomość tego rozwiązania nadal ma praktyczną wartość w kilku sytuacjach:
- utrzymujesz system mainframe albo aplikację napisaną w COBOL-u,
- analizujesz starszą bazę korzystającą z technologii IDMS lub podobnej,
- migrujesz dane do systemu relacyjnego,
- uczysz się historii modeli danych i chcesz lepiej zrozumieć ewolucję SQL,
- projektujesz system, w którym najważniejsze są stałe, bardzo szybkie ścieżki dostępu.
Podczas migracji największym błędem jest mechaniczne przepisanie każdego rekordu do osobnej tabeli. Najpierw trzeba odtworzyć znaczenie ownerów, members, zbiorów i wskaźników, a dopiero potem zaprojektować klucze główne, obce i tabele łącznikowe. Inaczej łatwo przenieść fizyczną strukturę bez zachowania sensu biznesowego.
Przeczytaj również: ERD - Projektowanie baz danych bez błędów. Jak to zrobić?
Jak podejść do analizy starej bazy
- Spisz wszystkie typy rekordów i ich pola.
- Zidentyfikuj ownerów oraz członków każdego zbioru.
- Rozrysuj kierunki przejść, także te używane tylko przez pojedyncze moduły.
- Oddziel dane biznesowe od wskaźników i elementów technicznych.
- Dopiero na końcu odwzoruj relacje w tabelach lub innej docelowej technologii.
Takie podejście pozwala uniknąć utraty informacji o kolejności, obowiązkowości członkostwa i zależnościach między rekordami. W systemach starszego typu te szczegóły często są ukryte w kodzie aplikacji, a nie w dokumentacji schematu.
Najważniejsza lekcja z sieciowego sposobu myślenia
Ten model przypomina, że baza danych nie jest tylko pojemnikiem na wartości. Jej struktura wpływa na sposób pracy aplikacji, wydajność odczytu i łatwość rozwijania systemu. Relacje są równie ważne jak same rekordy, a ich niewłaściwe zaprojektowanie potrafi skomplikować projekt bardziej niż wybór konkretnego silnika.
Jeżeli uczysz się SQL i Pythona, potraktuj model sieciowy jako ważny etap historii baz danych. Zrozumienie różnicy między nawigacyjnym przechodzeniem po rekordach a deklaratywnym zapytaniem SQL ułatwia później projektowanie schematów, analizę wydajności i ocenę starszych aplikacji.
Najkrócej mówiąc, sieciowe podejście dobrze radzi sobie z przewidywalnymi, mocno powiązanymi operacjami, lecz płaci za to złożonością i mniejszą swobodą zmian. Do nowej aplikacji najczęściej wybrałbym relacyjną bazę danych, ale przy modernizacji systemu dziedziczonego znajomość rekordów, zbiorów i wskaźników może oszczędzić wiele błędnych decyzji.