Gdy tabela rośnie do setek tysięcy lub milionów rekordów, zwykłe wyszukiwanie może zamienić proste zapytanie w długie oczekiwanie. Dobrze zaplanowane indeksowanie bazy danych skraca drogę do potrzebnych danych, ale źle dobrane indeksy potrafią zwiększyć rozmiar bazy i spowolnić zapisy. Pokażę, jak działają indeksy, kiedy ich używać, jak tworzyć je w SQL oraz jak sprawdzić, czy rzeczywiście poprawiają wydajność.
Dobrze dobrany indeks skraca drogę do danych, ale nie zastępuje dobrego zapytania
- Indeks pozwala szybciej odnaleźć rekordy bez przeglądania całej tabeli.
- Najczęściej warto indeksować kolumny używane w WHERE, JOIN, ORDER BY i ograniczeniach unikalności.
- Indeks przyspiesza odczyt, ale zwiększa koszt INSERT, UPDATE i DELETE.
- W indeksie złożonym kolejność kolumn ma bezpośredni wpływ na jego użyteczność.
- Skuteczność zmian należy sprawdzać planem wykonania, na przykład przez EXPLAIN.
Jak indeks przyspiesza odczyt danych
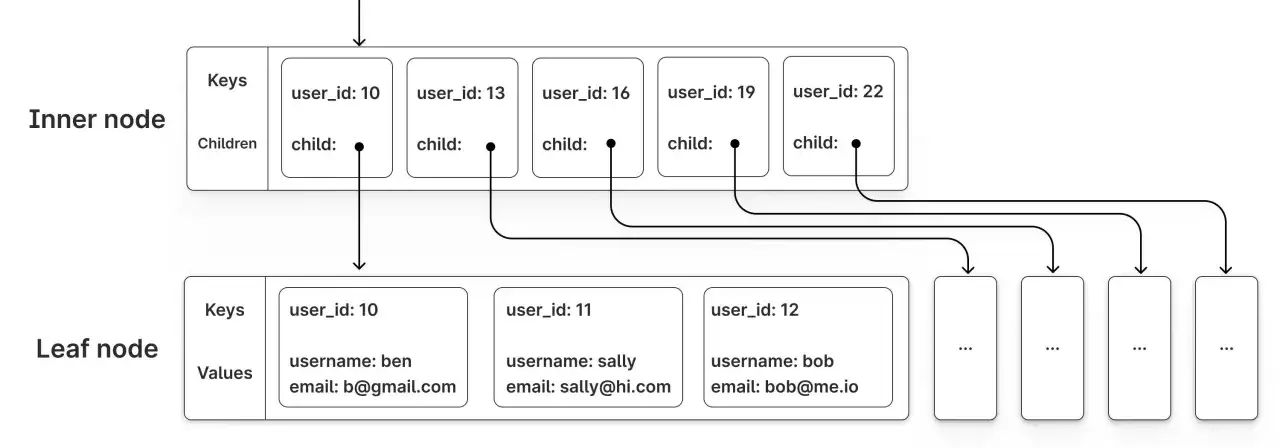
Indeks jest dodatkową strukturą, która przechowuje wartości wybranych kolumn oraz odnośniki do odpowiednich wierszy. Można porównać go do indeksu w książce. Zamiast czytać każdą stronę po kolei, baza może przejść bezpośrednio do fragmentu zawierającego szukaną informację.
Bez indeksu silnik często wykonuje skanowanie całej tabeli. Przy kilku tysiącach rekordów różnica może być niezauważalna, ale przy dużej tabeli oznacza odczyt znacznej liczby stron z dysku lub pamięci. Indeks nie sprawia, że każde zapytanie staje się natychmiastowe, jednak ogranicza ilość danych, które trzeba sprawdzić.
Najpopularniejszą strukturą jest B-tree, czyli zbalansowane drzewo pozwalające sprawnie obsługiwać równość, zakresy i sortowanie. Dobrze sprawdza się przy warunkach takich jak id = 42, price > 100 albo created_at BETWEEN ....
Sam fakt istnienia indeksu nie gwarantuje jego użycia. Optymalizator wybiera plan na podstawie rozmiaru tabeli, rozkładu wartości, statystyk i przewidywanego kosztu. Czasem szybsze okazuje się przeczytanie całej małej tabeli niż przejście przez indeks i późniejsze pobieranie rekordów.
Kiedy indeks pomaga, a kiedy obciąża bazę
Najlepszymi kandydatami są kolumny często wykorzystywane w filtrach, połączeniach tabel i sortowaniu. W praktyce zaczynam od analizy najwolniejszych zapytań, a nie od tworzenia indeksu dla każdej kolumny „na wszelki wypadek”.
- kolumny używane w WHERE, szczególnie przy dużych tabelach,
- kolumny łączące tabele w klauzuli JOIN,
- pola używane w ORDER BY i czasem w GROUP BY,
- kolumny objęte ograniczeniem UNIQUE,
- często wyszukiwane identyfikatory, adresy e-mail lub numery zamówień.
Indeksy mają jednak swoją cenę. Każdy dodatkowy indeks zajmuje miejsce i musi być aktualizowany przy dodawaniu, zmianie oraz usuwaniu wierszy. Na tabeli intensywnie modyfikowanej nadmiar indeksów może więc wyraźnie zwiększyć czas operacji zapisu i obciążenie pamięci.
Nie warto indeksować kolumny tylko dlatego, że istnieje. Pole o bardzo małej liczbie różnych wartości, na przykład kolumna is_active zawierająca niemal wyłącznie TRUE, może nie dać większej korzyści. Jeśli zapytanie i tak zwróci większość tabeli, indeks nie ograniczy wystarczająco liczby odczytów.
Typowym błędem jest też oczekiwanie, że zwykły indeks B-tree przyspieszy warunek LIKE '%python%'. Początkowy znak procenta uniemożliwia skuteczne wykorzystanie klasycznej kolejności indeksu. Dla wyszukiwania pełnotekstowego lepiej użyć mechanizmu full-text search albo rozwiązania dostosowanego do konkretnego silnika.
Jak utworzyć indeks w SQL
Podstawowa składnia jest prosta i podobna w wielu systemach:
CREATE INDEX idx_users_email
ON users (email);
To polecenie tworzy indeks na kolumnie email tabeli users. Jeśli adres e-mail ma być unikalny, lepszym rozwiązaniem będzie indeks unikalny:
CREATE UNIQUE INDEX idx_users_email_unique
ON users (email);
W wielu przypadkach ograniczenie UNIQUE lub klucz główny automatycznie tworzy odpowiednią strukturę. Dzięki temu baza nie tylko szybciej wyszukuje rekordy, lecz także pilnuje integralności danych.
Przykład indeksu dla tabeli zamówień może wyglądać tak:
CREATE INDEX idx_orders_customer
ON orders (customer_id);
Indeks na customer_id może pomóc zarówno przy wyszukiwaniu zamówień konkretnego klienta, jak i przy łączeniu tabel orders i customers. Ostateczna decyzja zależy od rzeczywistych zapytań i liczby rekordów.
Składnia szczegółowych opcji różni się między PostgreSQL, MySQL, SQL Server i Oracle. Przed wdrożeniem sprawdzam dokumentację używanego silnika, ponieważ nazwy typów indeksów, obsługa indeksów częściowych i zachowanie klucza klastrowanego nie są takie same.
Jak dobrać kolumny i kolejność w indeksie złożonym
Indeks złożony obejmuje więcej niż jedną kolumnę. Jest przydatny, gdy zapytania regularnie filtrują dane według kilku pól jednocześnie:
CREATE INDEX idx_orders_customer_status_date
ON orders (customer_id, status, created_at);
Kolejność nie jest przypadkowa. Taka struktura może pomóc przy warunkach dotyczących customer_id oraz przy połączeniu customer_id i status. Zwykle będzie natomiast znacznie mniej przydatna dla zapytania filtrującego wyłącznie po status, ponieważ ta kolumna nie znajduje się na początku indeksu.
Przy wyborze kolejności analizuję trzy rzeczy. Pierwsza to sposób filtrowania danych, druga to selektywność, czyli zdolność kolumny do ograniczania liczby wyników, a trzecia to sortowanie i zakresy. Nie ma jednej uniwersalnej zasady, że zawsze pierwsza powinna być kolumna o największej liczbie unikalnych wartości.
Dobrym przykładem jest lista zamówień klienta:
SELECT id, created_at, total
FROM orders
WHERE customer_id = 42
  AND status = 'paid'
ORDER BY created_at DESC;
Dla takiego zapytania indeks obejmujący customer_id, status i created_at może ograniczyć filtrowanie oraz potrzebę dodatkowego sortowania. Trzeba jednak sprawdzić plan wykonania, bo przy małej tabeli zysk może być zbyt mały, aby uzasadnić dodatkowe miejsce i koszt zapisu.
W niektórych silnikach można dodać do indeksu kolumny, które nie służą do wyszukiwania, ale pozwalają odczytać wynik bez sięgania do tabeli. Takie indeksy pokrywające bywają skuteczne, lecz łatwo je nadmiernie rozbudować. Zbyt szeroki indeks zwiększa rozmiar struktury i spowalnia jej aktualizację.
Najważniejsze typy indeksów i ich zastosowania
Typ indeksu powinien wynikać z rodzaju danych oraz zapytań. Najczęściej spotkasz kilka wariantów:
| Typ indeksu | Najlepsze zastosowanie | Ograniczenie |
|---|---|---|
| B-tree | Równość, zakresy, sortowanie | Nie rozwiązuje dobrze wyszukiwania z prefiksem %
|
| Hash | Wyszukiwanie dokładnej wartości | Zwykle nie służy do zakresów i sortowania |
| Full-text | Wyszukiwanie słów w dużych tekstach | Ma własne zasady wyszukiwania i indeksowania |
| Złożony | Zapytania filtrujące po kilku kolumnach | Kolejność kolumn ma duże znaczenie |
| Częściowy lub filtrowany | Wybrany podzbiór rekordów | Nie każdy silnik obsługuje go w taki sam sposób |
Indeks częściowy jest ciekawy, gdy aplikacja często pobiera tylko jeden rodzaj rekordów. W PostgreSQL można na przykład utworzyć indeks wyłącznie dla otwartych zamówień:
CREATE INDEX idx_orders_open
ON orders (created_at)
WHERE status = 'open';
Taka struktura może być mniejsza niż indeks całej tabeli, ale zadziała tylko wtedy, gdy zapytanie pasuje do warunku indeksu. W MySQL podobny efekt często wymaga innego modelu danych lub kolumny pomocniczej, dlatego nie należy bezpośrednio przenosić składni między systemami.
Indeksy funkcyjne przydają się wtedy, gdy zapytanie filtruje po wyniku funkcji, na przykład po znormalizowanym adresie e-mail:
CREATE INDEX idx_users_lower_email
ON users (LOWER(email));
To rozwiązanie ma sens tylko wtedy, gdy zapytanie używa tej samej transformacji. Bez zgodności wyrażenia optymalizator może pominąć indeks. W SQL Server podobną potrzebę często realizuje się przez kolumnę obliczaną i indeks na jej wyniku.
Jak sprawdzić, czy indeks naprawdę działa
Po utworzeniu indeksu nie zakładam automatycznie poprawy. Najpierw mierzę zapytanie przed zmianą, później tworzę indeks i ponownie porównuję czas wykonania, liczbę odczytanych stron oraz plan zapytania.
W PostgreSQL służy do tego między innymi:
EXPLAIN (ANALYZE, BUFFERS)
SELECT *
FROM orders
WHERE customer_id = 42;
W MySQL można użyć EXPLAIN lub EXPLAIN ANALYZE, a w SQL Server przydatne są plan wykonania oraz statystyki odczytu. Szukam informacji, czy silnik wykonał skan indeksu, wyszukiwanie po indeksie i ile wierszy faktycznie odczytał.
Trzeba odróżnić plan przewidywany od rzeczywistego. Optymalizator może zakładać, że zapytanie zwróci niewiele rekordów, choć w praktyce wynik jest bardzo duży. Nieaktualne statystyki również prowadzą do nietrafionych decyzji, dlatego po dużych zmianach danych warto zadbać o ich odświeżenie zgodnie z zasadami danego silnika.
Jeśli indeks nie jest używany, sprawdzam kilka typowych przyczyn:
- tabela jest zbyt mała, aby indeks dawał zauważalną korzyść,
- warunek zwraca dużą część wszystkich rekordów,
- zapytanie nakłada funkcję, rzutowanie lub obliczenie na indeksowaną kolumnę,
- kolumny w indeksie złożonym występują w nieodpowiedniej kolejności,
- statystyki są nieaktualne,
- indeks jest zbyt szeroki albo dubluje inną strukturę.
Dokumentacja Microsoft Learn słusznie zwraca uwagę, że zarówno brak indeksów, jak i ich nadmiar lub zły projekt mogą prowadzić do problemów z wydajnością. To dobry powód, aby podejmować decyzje na podstawie planów wykonania, a nie popularnych recept typu „załóż indeks na każdą kolumnę z WHERE”.
Typowe błędy przy zarządzaniu indeksami
Pierwszy błąd to tworzenie wielu podobnych indeksów bez sprawdzenia, czy jeden z nich już pokrywa dane zapytanie. Duplikaty zwiększają koszty zapisu, a niekoniecznie przyspieszają odczyt. Warto regularnie przeglądać użycie indeksów i usuwać te, które są nieużywane, redundantne lub pozostały po starej wersji aplikacji.
Drugi problem to indeksowanie kolumn o dużej długości, zwłaszcza tekstowych, bez wyraźnego powodu. Taki indeks może zajmować dużo miejsca i generować koszt podczas modyfikacji rekordów. Jeśli zapytania potrzebują jedynie skróconej wartości, czasem lepsza będzie osobna, znormalizowana kolumna.
Trzeci błąd polega na ignorowaniu zapytań aplikacji. Indeks powinien wynikać z realnego obciążenia, a nie wyłącznie ze struktury tabeli. Jedna aplikacja może głównie wyszukiwać po dacie, inna po identyfikatorze klienta, a jeszcze inna wykonywać ciężkie raporty agregujące dane.
Indeksy również wymagają konserwacji, choć sposób i częstotliwość zależą od silnika, rodzaju obciążenia oraz skali zmian. Reorganizacja, przebudowa, analiza statystyk i monitoring powinny być elementem normalnego utrzymania większej bazy, a nie reakcją dopiero na poważne spowolnienie.
Jak podejść do indeksów w projekcie z Pythonem
W aplikacji napisanej w Pythonie indeksy tworzyłbym przez migracje, a nie ręcznie na produkcyjnej bazie. Narzędzia takie jak Django migrations, Alembic czy SQLAlchemy pozwalają zapisać zmianę schematu razem z kodem i odtworzyć ją w różnych środowiskach.
Przed wdrożeniem sprawdzam plan na danych zbliżonych do produkcyjnych. Testowa baza z kilkuset rekordami może pokazać zupełnie inny plan niż system zawierający miliony wierszy. Szczególną ostrożność zachowuję przy tworzeniu indeksu na dużej, intensywnie używanej tabeli, ponieważ sama operacja może czasowo zwiększyć obciążenie i zablokować część operacji, zależnie od silnika oraz użytych opcji.
Najzdrowszy proces wygląda tak:
- znajdź wolne lub często wykonywane zapytanie,
- zmierz jego działanie i obejrzyj plan wykonania,
- zaprojektuj najmniejszy indeks odpowiadający konkretnemu problemowi,
- utwórz go przez migrację,
- porównaj wyniki na realistycznych danych,
- monitoruj wpływ na odczyty, zapisy i rozmiar bazy.
Indeks powinien rozwiązywać konkretny problem
Najlepszy indeks nie jest tym, który ma najwięcej kolumn, lecz tym, który odpowiada na rzeczywiste zapytanie i ogranicza liczbę odczytywanych danych. Zaczynam od pomiaru, dobieram strukturę do wzorca zapytań, a dopiero później oceniam szczegóły takie jak typ, kolejność czy pokrycie dodatkowych kolumn.
Jeżeli po dodaniu indeksu odczyt przyspieszył, ale zapisy stały się wyraźnie wolniejsze, trzeba ocenić cały bilans. Czasem lepsza będzie mniejsza struktura, indeks częściowy albo poprawa samego zapytania. Indeks jest narzędziem optymalizacji, nie uniwersalnym lekarstwem, dlatego jego wartość zawsze mierzę w konkretnym systemie i przy rzeczywistym obciążeniu.